原帖 | 立芯嵌入式 | 2026-08-15 01:05 | 👍1 | 阅读约1
一个 616 KB 的模型,凭什么管住整副 AI 眼镜
我们最近把自研的"你好,立芯"唤醒模型部署进了 ESP32-S3 眼镜固件,跑通了从端侧唤醒到眼镜播报再到恢复监听的完整链路。
今天不展开讲整条链路的工程细节,主要聊聊这个唤醒模型本身,它小到什么程度、做了什么事、为什么比看上去难得多。
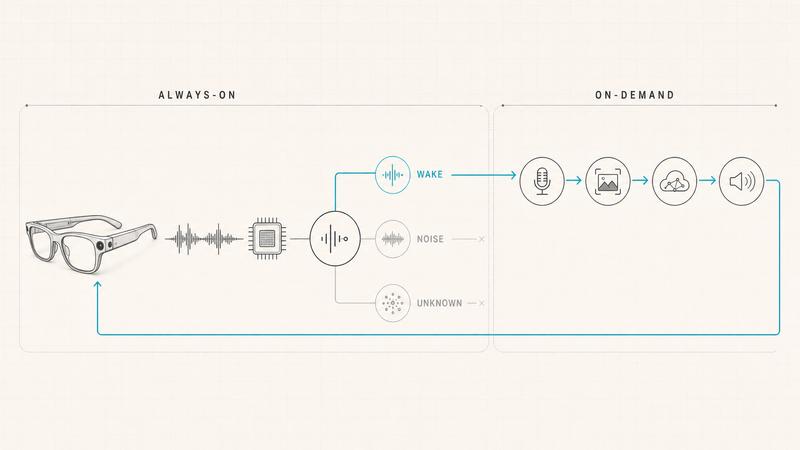
先看几个数字。模型总大小 615,688 字节,不到 616 KB。推理运行时占用 256 KB RAM。它读取板载 PDM 麦克风的 16 kHz 单声道音频,每 250 ms 处理一帧,四帧拼成约一秒的滑动窗口,输出三个分数:唤醒词、环境噪声、未知语音。int8 量化,TFLite Micro 推理。
616 KB 是什么概念?一张手机照片通常 3-5 MB,一个微信表情包可能都比它大。但就是这个体量的模型,7×24 小时守在系统最前面,决定麦克风、相机、云端 AI 和扬声器什么时候启动。
科普一下它在做的事情。很多人以为唤醒词是语音识别的简化版,把"你好立芯"四个字识别出来就行了。不是这样。语音识别是把声音转成文字,计算量大、模型大、通常需要云端。唤醒词做的事情完全不同——它不需要知道你说了什么字,它只需要判断最近一秒的声音"像不像"目标词的声学模式。
具体来说,模型拿到一段原始音频后,先做预处理提取频谱特征,然后喂进一个很小的分类网络。这个网络不输出文字,只输出三个概率分数。你可以理解成它在持续回答一个问题:"刚才那一秒的声音,更像是有人在叫我,更像是背景噪声,还是更像是别的什么人声?"
它每 250 ms 回答一次这个问题,一小时回答 14400 次,一天回答将近 35 万次。
这就引出了这个模型真正难的地方。成功识别一次"你好立芯"不难,难的是在这 35 万次判断里,该醒的时候醒,不该醒的时候安静。
一次误唤醒在实验室里只是分类错了一次。但在眼镜上,它会连锁拉起录音、拍照、云端请求,一个判断错误被放大成功耗、流量和隐私问题。我们早期测试就遇到过"你好真心""你好乐鑫"这类近音词触发的情况,这不是调一个阈值能解决的。
训练数据里的负样本质量在这里起决定性作用。正样本决定模型能不能醒,大量的噪声样本和近音硬负样本决定它能不能安静。而且这些负样本不能只用公开数据集凑,必须包含真实佩戴环境里录到的声音——教室、地铁、多人交谈、风噪,每一种场景都是一组不同的干扰分布。
调参也全是取舍。阈值拉高能压住误唤醒,但小声、远距离、口音不同的用户就更难喊醒。滑动窗口缩短能让响应更快,但模型能观察到的上下文也变少了,判断置信度会下降。没有通用最优参数,只能拿真实佩戴数据去迭代。
还有一层很多人没想过的工程问题:唤醒之后怎么办。眼镜播放"你好,我在"的时候,扬声器的声音会被自己的麦克风再次采集到。如果不做状态管理,模型可能把自己的回复识别成新的唤醒词,进入死循环。所以系统内部需要维护监听、暂停、提示、冷却、故障等一组状态,协调麦克风和扬声器的所有权。蓝牙断连后旧会话的唤醒事件也不能重新启动语音链路,故障时默认关闭候选能力而不是带病运行。
这些东西在一次演示里看不出来,但它们决定了这个方案能不能真正在头上戴一天。
说到底,这个 616 KB 的模型做的事情是:用最小的计算代价,在设备本地完成一个 always-on 的第一道判断——"用户是不是在叫我"。只有确认了交互意图,才把语音识别、视觉理解、大模型推理这些昂贵的能力按需拉起。
附件:
- 新一代智能终端蓝皮书.pdf(2.4MB)
相关笔记